2016年3月22日火曜日

RMeCabのインストール

RにはRMeCab(石田基広氏による)というテキスト処理を行うためのパッケージがあり、日本語文章の解析ができるようになります。RMeCabは、MeCab(工藤拓氏による)という形態素解析ソフトと連携して動作しています。形態素解析は文章を形態素に分解し、各形態素の品詞を特定します。形態素は「意味を持つ語の最小単位」です。
で、RMeCabをインストールします。まず、準備としてMeCabをダウンロードし、インストールします。OSとしてWindowsを想定しています。MeCabは、http://taku910.github.io/mecab/ からダウンロードできます。

「ダウンロード」にある「Binary package for MS-Windows」の下、「mecab-0.996.exe」横のダウンロードをクリックします。ファイルがダウンロードできたら、この実行ファイルをダブルクリックします。そうすると、インストールが始まります。幾つかポップアップ画面が出て来ますが、defaultのままOKでよいです。

MeCabは、CドライブのProgram Files (x86)の中に入ります。Windowsではこれで辞書もインストールされますので、すぐRMeCabを使えます。Windowsならば、desktopに「MeCab」アイコンができているはずですから、これをダブルクリックします。もし見当たらなければ、menuから「MeCab」を選択して起動します。ウィンドウ画面が出てきますので、何か文章を入力します。で、形態素解析の結果が表示されれば、MeCabが正常にインストールされたことがわかります。

次に、RMeCabをインストールします。RMeCabは石田基広氏によって開発され、Rのinstall.packagesでインストールできます。RStudioを起動し、以下のコマンドを実行してインストールします。
install.packages("RMeCab", repos = "http://rmecab.jp/R")

インストールに成功したら、以下のコマンドを入力して、正常にインストールされたことを確認します。
> library(RMeCab)
> rmec <- RMeCabC("私は誰だ。")
> unlist(rmec)
  名詞   助詞   名詞 助動詞   記号
   "私"   "は"   "誰"   "だ"   "。"
>

2016年3月12日土曜日

Rのインストール

 統計解析ツールRのインストールの仕方をやっていませんでした。Rをインストールする機会がありましたので、ここに記録しておきます。Rのインストールの仕方については、書籍やネット上に情報がありますから、それも参考にして下さい。
 表計算ならExcelでもできますし、コマンドを打たなければいけないという面倒さはありますが、ちょっとした統計解析を行うなら、便利な関数が色々用意してあるRが良いようです。
  Rは、Rプロジェクトのホームページ(https://www.r-project.org/)からダウンロードします。このURLに行くと、以下のようなページが出てきます。
左側のメニューで、Downloadの下にある「CRAN」をクリックします。
と、このようなページが現れます。これはダウンロードサイトのリストで、日本のサイトはページの中程にあります。
どれかを選択してクリックしますと、このようなページが出現します。ここではOSとしてWindowsを使っていることを仮定して、「Download R for Windows」をクリックします。
そうすると、このようなページが表示されます。baseをクリックします。
2016年3月時点ではR-3.2.4が最新です。「Download R-3.2.4 for Windows」をクリックしますと、ダウンロードを開始します。 で、ダウンロードが完了したとします。ダウンロードされたファイルをダブルクリックします。
インストールプログラムが起動します。これは使用言語の選択で、自動的に「日本語」が選択されています。「OK」をクリックします。
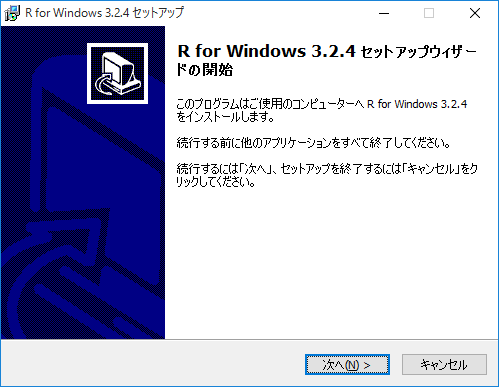
セットアップウィザードが立ち上がりますので、そのポップアップ画面の下辺りにある「次へ」ボタンをクリックしていきます。ライセンスや設定について確認してきますが、取りあえず「次へ」ボタンでも大丈夫です。
このようにインストールが始まります。
インストールが終了すると、このような画面が出てきます。「完了」ボタンをクリックします。
インストールのセットアップ時に何も変更を加えなければ、このようなアイコンがデスクトップに出現します。64ビット機PCなら「R x64 3.2.4」と「R i386 3.2.4」とありますが、「R x64 3.2.4」を使います。これをダブルクリックします。
このような画面が表示されていれば、インストール成功です。「R Console」に右矢印「>」が、表示されています。これはプロンプトと呼ばれ、コマンドを入力できる状態であることを表します。Rを終了するコマンド「q()」を入力すると、Rが終了します。
このとき、このようなポップアップ画面が現れ、データを保存するかどうかを訊いてきます。データを保存するなら、必ず「はい」ボタンをクリックします。

2016年1月11日月曜日

数値の分類

 「1月の最低気温1度の日に、10km走に出場し、45分40秒で完走でき、880番だった。」
 この一文は日常よく耳にするものであり、取り立てて専門的な知識が無くても理解できます。一般的な情報であり、年明けの寒い日に、マラソン大会か何かに出場して、45分40秒で走った、、、もの凄く速いというわけでもないですが、そんなに遅いわけでもないです。これで880番ということは、この大会の出場者は割合多いのではないか、くらいの想像はつくでしょう。ところが、これらの数値は、厳密に言うと別々の尺度となります。
 心理学者Dr. Stanly Smith Stevensは「On the theory of scales of measurement」の中で、数値を「名義尺度」「順序尺度」「間隔尺度」「比例尺度」に分類しています。名義尺度は何かを分類するための便宜的な名前であり、ラベルのようなものです。例えば、性別や職業、話題などを区別する場合です。性別であれば、男を1、女を2にするし、職業なら、スポーツ選手を1、デザイナーを2、編集者を3、歌手を4、小説家を5、学芸員を6といった具合です。数値を入れ換えても本質的に影響ないし、区別するための数値なので、その大きさにも意味がありません。順序尺度は順序関係を表し、順序に意味があります。例えば、競技結果の順序やサービス満足度などです。前者は1番、2番といったものであり、後者は1:とても満足、2:やや満足、3:やや不満、4とても不満といった数値です。値が等しいのか、大きいのか、小さいのかが比較できるが、加減算はできません。間隔尺度は等間隔の目盛り上の数値を表し、一定の単位で測られた量を意味します。例えば、気温や年月、試験の成績などです。数値が等しいか、大きいか、小さいかの比較ができるし、その差にも意味がああります。加減算は可能だが、ゼロ(原点)でも「無」というわけではない点に注意を要します。比例尺度は原点が定義されていて、目盛りは等間隔です。例えば、身長や体重、質量や長さ、金額などです。数値の比較、数値の差に意味があり、加減乗除ができます。
 このようにして考えると、「1月の最低気温1度の日に、10km走に出場し、45分40秒で完走でき、880番だった。」という文は、少し違った見方ができます。1月、1度は間隔尺度、10km、45分40秒は比例尺度、880番は順序尺度です。データ分析を行うときは、数値の分類を考えておく方が間違いが少ないです。

2015年12月18日金曜日

データ分析の流れ

 「ビッグデータを活かすデータサイエンス」では、ビジネスにおけるデータ分析の流れを、「現状とあるべき姿」「問題発見」「データ収集と加工」「データ分析」「アクション」に分けている。「現状とあるべき姿」は、現状を把握し、本来どうあるべきなのかを考えることである。両者のギャップが、問題になる。このとき、問題の要因を探すのに、「影響度合い」「分解」「比較」という観点で見るのがよいと主張している。「影響度合い」は、ギャップの要因が、結果に対してどの程度影響するのかである。「分解」は、ギャップの要因をより細かな要素の分解する。このとき、MECEになるようにするとよい。MはMutually(要素を互いに)、EはExclusive(重複なく)、CはCollectively(漏れなく集める)、EはExhaustive(全体を尽くす)である。「比較」は、問題が起きているときのデータと、そうでないときのデータを比較する。時系列に、類似商品や類似サービスという観点で比較するとよい。「データ収集と加工」は、データ収集にも時間とコストがかかるから、「どんなデータが必要なのか考えろ」ということである。データは分析しやすい形に成型されているとは限らない。この加工は、その後の分析を効率的にできるかを決める。「データ分析」は、ビジネスでは「意思決定支援」と「自動化・最適化」に分けられる。「意思決定支援」は、問題解決のためのアクションを、人間が決定・実行するのを支援するのが目的である。人間が状況を理解して、適切な判断ができるようにする。単純で、理解しやすいモデルが効果的とされる。「自動化・最適化」は、問題解決のためのアクションをコンピュータに実行させるためのアルゴリズムを構築する。機械学習の手法を使う。「アクション」は、分析結果に基づいてアクションを実行するかどうかを決める。

2015年12月16日水曜日

データサイエンティスト

 巷で、データサイエンティストと呼ばれる人たちが出現しつつあります。メディアなどで取り上げられ、急速にその存在感を増しています。その背景にはビッグデータをビジネスに活かそうとする、企業側の動きがあります。社内外のデータを使って、自社のビジネスに役立つ情報を得ようと、データ分析を行うのです。  2013年7月、日本経済新聞は、「ビッグデータ分析に人材の壁、25万人不足の見通し、、、」という記事を掲載しました。この記事の中に、「政府は関連ビジネスの経済効果を7兆円超と試算、、、」なんて文言が入っています。ってことは、データサイエンティストになれば、引く手あまたってこと?と思ってしまいます。それに、「ハーバード・ビジネスレビュー」誌が、データサイエンティストを「21世紀で最も魅力的(セクシー)な職業」と書いたものだから、その認知度が進んだのです。  でも、このデータサイエンティストという職業には、決まった定義が存在しないようです。色んな背景を持った人たちがデータ分析に携わってきたから、当然と言えば当然です。今は流行だから、何でもありの状態になっていますが、その内淘汰されていくのでしょう。ただ、統計学やITに関する専門知識を持っているだけでは十分ではないと言われています。「統計学×IT×ビジネスの領域横断のクロス人材」(橋本大也)という人もいれば、「データサイエンティストとは、自分に関わる人すべてが理解できる言葉でコミュニケーションを図り、言葉と視覚、理想的にはその両方を使って、データで物事を語るという特殊なスキルを持つ人」という人(先の「21世紀で最も魅力的(セクシー)な職業」を書いた人たち)もいます。後者はビジネスに関する知識やスキルまで要求していないようですが、前者はマーケティングを含むマネージメントの知見が要ります。

2015年8月30日日曜日

インフルエンザ流行の予測

 Google Flu Trend(インフルトレンド)は、検索語句に基づいてインフルエンザの流行を予測するもので、2009年に論文が発表されました。それを見て、「こんなことができるのか」と感心したものです。アメリカでは、CDC(アメリカ疾病予防管理センター)がインフルエンザの流行に関する統計データを出しています。これには1-2週間の時間遅れが含まれるようですが、インフルトレンドはほぼリアルタイムで結果を出します。下図が、日本のインフルエンザ流行の推移です。インフルトレンドの予測は、実際のデータによく合っているように見えます。

 アメリカの予測に使ったデータは、以下の2種類です。
・過去5年間(2003-2008年)のGoogle検索に入力された検索語句
・アメリカの9つの地域でインフルエンザによって病院を訪れた患者の数(CDCが週単位で発表)
検索語句の上位5千万件を選んで、週単位の検索数(を総検索数で規格化)とCDCのデータとの相関関係を調べます。膨大な数式モデルを使って検索語句を分析し、CDCが提供しているインフルエンザ症例とを比較しました。そこで、特定の検索語45個と、ある数式モデルを組み合わせたとき、グーグルの予測とCDCデータとの間に高い相関関係が見られました。これで、GoogleがCDCと同じように、インフルエンザがどこで流行しているのか特定できたわけです。
 ところが、Googleのインフルトレンドが、インフルエンザの流行を過大評価していたとの記事が「サイエンス」誌から発表されました。2011年8月から誤った予測を出し続けていたといいます。確かに、近年の流行予測は多くなる傾向が続いていて、変だなという感じはありました。やはり、データの相関だけでは限界があるのでしょうか、、、。

2015年8月19日水曜日

ビッグデータの正体

 ビクター・マイヤー=ショーンベルガー著「ビッグデータの正体」には、「ビッグデータの衝撃」よりも、衝撃的な内容が書いてありました。ビッグデータの定義として、「小規模ではなしえないことを大きな規模で実行し、新たな知の抽出や価値の創出によって、市場、組織、さらには市民と政府の関係などを変えること」というのは、全うでしょう。しかし、「全てのデータを扱う」「量さえあれば、精度は重要ではない」「因果関係ではなく相関関係が重要になる」という3つの変化で述べられている内容は、なかなか刺激的です。
 1つ目は、標本をベースとした確率への挑戦です。「すべて」というところが重要で、無作為抽出で得られた標本でないから、その中で起きていることが細かく分析できると主張しています。2つ目は、「質より量」という話であす。量が増えれば、不正確なものが入り込みます。不正確なものが混じっていても、正確なものが大量にあれば、許容できると主張しています。大量にあることのメリット(変化を捉えるとか)を活かそうということです。3つ目は、結果がより重要視され、その原因はあまり重要で無くなるというものです。「こうなったら、こうなる」という関係だけわかれば、ビジネスはできます。なぜ、そうなるのかの理由は必要ありません。今一すっきりしないやり方ですが、とにかく結果がそうなるのだから、説明は求めないことにするのです。